Als ich cv_v47_dataeng_final_v2.docx öffnete, wusste ich bereits, dass ich an diesem Abend keine weitere Bewerbung mehr abschicken würde. Es war ein Sonntag Ende 2023. Die Tracker-Tabelle, seit einer Woche ungeöffnet, versteckte sich hinter drei anderen Tabs, die ich benutzt hatte, um sie nicht ansehen zu müssen. Elf Zeilen unter "Applied". Keine unter "Responded". Mein Rücken schmerzte nach eineinhalb Tagen im Sitzen; der Browser-Tab neben dem CV war ein Kaggle-Notebook, das ich an jenem Morgen geöffnet und seither nicht wieder angerührt hatte. Ich klappte das Laptop zu.
In jenem Jahr war eine ernsthafte Jobsuche sehr zeitaufwendig geworden. Jede Stunde, die ich damit verbrachte, dieselben drei Positionen in einer leicht anderen Reihenfolge zu ordnen, war eine Stunde, die ich nicht in die Projekte steckte, die mich eigentlich attraktiver auf dem Arbeitsmarkt machen sollten. Jede Version des CV, darunter cv_v46 und cv_v47, tauschte ein Keyword-Cluster gegen ein anderes. Jeder lange Abend am Schreibtisch endete mit demselben leichten Ziehen im unteren Rücken und demselben ungeöffneten Tracker. Das Zuschneiden der Bewerbungen war zu einer Vollzeitaufgabe geworden und kostete genau die Stunden, in denen ich meine Fähigkeiten hätte verbessern sollen.
Manche Ingenieure lösen ihre eigenen Probleme mit Nebenprojekten. Ich stellte mir eine Regel auf: Wenn ich diesem Markt das nächste Mal begegnete, würde ich das nicht von Hand erledigen. Zweieinhalb Jahre später, mit dem Abschluss vor Augen und einer Masterarbeit, die noch fertig werden musste, stand hinter dieser Regel ein Plan. Nach Abgabe meiner Masterarbeit wollte ich das Tool bauen, das mir jene Sonntagabende erspart hätte: ein System, das die mechanische Hälfte einer Jobsuche übernimmt, damit mir Zeit für die menschlichen Entscheidungen bleibt (ob ich mich bewerbe, ob ich annehme, wofür ich die gewonnenen Stunden nutze).
Im März fand ich online ein Open-Source-Projekt, das bereits die Hälfte dessen konnte, was ich brauchte.
Als ich mich eines Mittags durch meinen Feed scrollte, stieß ich auf einen Beitrag über ein Open-Source-Projekt namens career-ops. Sein Autor, Santiago Fernández de Valderrama, hatte damit mehr als 740 Stellenanzeigen bewertet, auf seinem Weg zu einer Position als Head of Applied AI. Er hatte in aller Öffentlichkeit das gebaut, was ich seit Monaten in einem Notizbuch skizziert hatte. Die höfliche Reaktion wäre gewesen, den Tab zu schließen und meine eigene Version zu beginnen. Die nützliche Reaktion, zu der ich nach einem ganzen Tag Sturheit kam, war, sein Repo zu forken und mit dem Erweitern zu beginnen.
Wie sich der Arbeitsmarkt verändert hat
Bevor ich eigenen Code schrieb, wollte ich prüfen, ob meine Erinnerung an den Arbeitsmarkt zutraf oder durch den Burnout verzerrt war.
Die Daten bestätigten meine Erinnerung.
Laut Jobscan-Report 2025 nutzen 97,8 % der Fortune-500-Unternehmen auf ihren Karriereseiten ein Applicant Tracking System. Eine Studie der Harvard Business School von 2021 mit 2.275 Führungskräften aus den USA, dem Vereinigten Königreich und Deutschland ergab, dass mehr als neun von zehn Arbeitgebern, die ein solches System nutzen, sich beim ersten Filtern darauf verlassen, und 88 % räumen ein, dass ihre Systeme qualifizierte Kandidaten aussortieren. Der oft wiederholte Satz, ATS-Software lehne drei Viertel aller CVs ab, ist Folklore; die Zitierkette führt zu einem Verkaufsargument eines Anbieters aus dem Jahr 2012, der im Jahr darauf schloss. Das ehrliche Bild ist ohnehin schlimmer als der Mythos. Die Systeme ordnen CVs in eine Rangfolge und setzen nicht zugeschnittene CVs ans Ende der Liste; sie lehnen sie nicht automatisch ab.
Zuschneiden verschiebt die Wahrscheinlichkeiten. Plattformdaten aus über einer Million verfolgten Bewerbungen zeigen, dass zugeschnittene CVs etwa doppelt so häufig zu Interviews oder Angeboten führen wie generische. Aber das Volumen ist mitgewachsen. Bewerbungen auf Workday sind in der ersten Hälfte des Jahres 2024 viermal so schnell gewachsen wie ausgeschriebene Stellen. LinkedIn verarbeitet inzwischen rund 11.000 Bewerbungen pro Minute, ein Plus von 45 % im Jahresvergleich. Branchenberichte nennen für die durchschnittliche Absolventenstelle im Vereinigten Königreich rund 140 Bewerber. Zwischen 18 und 22 Prozent der Stellenanzeigen auf Greenhouse sind das, was der Congressional Research Service höflich "Ghost Jobs" nennt: Anzeigen, die Arbeitgeber nie wirklich besetzen wollen.
Am stärksten trifft der Druck die Einstiegspositionen. Die Einstellungen von Berufseinsteigern bei den großen Tech-Konzernen sind gegenüber 2019 um mehr als 50 % gefallen. Die Arbeitslosenquote von jungen Hochschulabsolventen in den USA liegt zum ersten Mal seit Jahrzehnten über der allgemeinen Quote. Stanfords Digital Economy Lab hat anhand von Payroll-Daten von 4,6 Millionen Beschäftigten einen anhaltenden Rückgang der Beschäftigung bei den 22- bis 25-Jährigen in den am stärksten KI-exponierten Berufen dokumentiert. Über die Ursache dieses Befunds sind sich Ökonomen uneinig (Daron Acemoglu ist skeptisch; die Ökonomen von Google machen die Zinsen verantwortlich), der Rückgang selbst ist jedoch unbestritten.
In diesem Markt sind präzise Bewerbungen wirksamer als eine hohe Anzahl, Präzision kostet Zeit, und deshalb lohnt es sich, diese Aufgabe zu automatisieren.
Lesen vor dem Schreiben
Als ich Santis Repo las, bevor ich etwas änderte, sah ich, dass er die meisten Probleme, die ich angehen wollte, bereits gelöst hatte. Er hatte das Bewertungsraster gebaut, das ich gebaut hätte, die Mode-Routing-Architektur, die Playwright-PDF-Pipeline, die Tracker-Disziplin und die ethische Regel, die jede Bewerbung damit enden ließ, dass ein Mensch, nicht eine Maschine, auf "Senden" klickt. Seine Codebase funktionierte, hatte Haltung und war in den meisten Punkten besser als meine Whiteboard-Skizzen.
Den britischen Arbeitsmarkt deckte sie nicht ab.
Santi hatte für das Ökosystem gebaut, in dem er sich bewarb. Ich brauchte etwas mit UK-Fokus: ein System, das wusste, dass ein britischer Arbeitgeber ein Skilled-Worker-Visum nur sponsern kann, wenn er im gov.uk-Register lizenziert ist, und das die nicht lizenzierten Arbeitgeber markierte, bevor ich einen Sonntag damit verschwendete, einen CV für ein Unternehmen zuzuschneiden, das mich rechtlich gar nicht einstellen konnte. Ich brauchte eine Anbindung an Notion, weil ich dort bereits meinen Alltag organisiere. Ich brauchte etwas, das mir ehrlich sagen konnte, ob sein eigenes Vertrauen in einen Match-Score überhaupt etwas wert war.
Also habe ich career-ops in der Woche, in der ich es fand, geforkt und begonnen, es zu erweitern. Vier Monate später läuft das System, das ich auf Santis Fundament gebaut habe, jeden Tag. Es heißt applyd, und ich schreibe dies jetzt, weil es Zeit ist, dass auch andere Menschen die Möglichkeit haben, es zu nutzen, und mir helfen, es weiterzubringen.
Eine gemeinsame Definition für alle Metriken
Die technische Entscheidung, auf die ich am stolzesten bin, hat fast nichts mit KI zu tun.
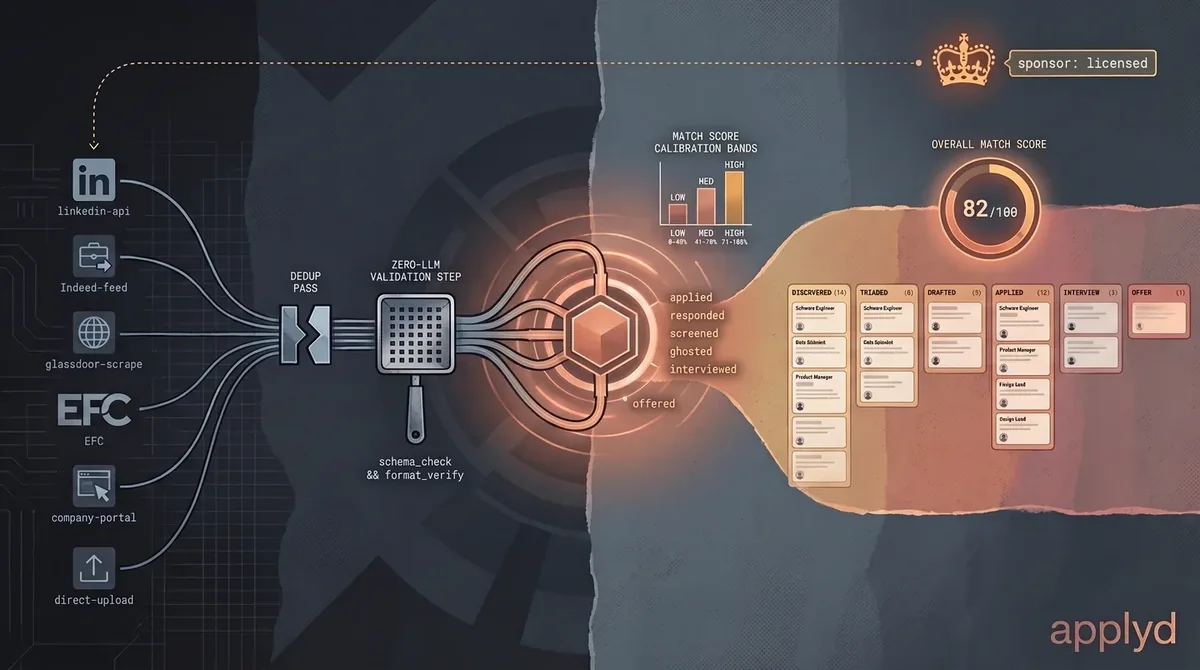
Frühe Versionen dessen, was ich baute, hatten sechs verschiedene Skripte, die Metriken erzeugten: einen Funnel-Report, eine Analyse von Ablehnungsmustern, eine Pacing-Alarmierung, ein Dashboard, eine Batch-Zusammenfassung und einen Follow-up-Rechner. Jedes Skript nutzte eine eigene Definition von "applied", "responded", "screened" und "ghosted". Zwei der Dashboards waren sich über meine Antwortrate uneins. Ich starrte einen Abend lang auf diese Diskrepanz, bevor ich sie verstand: Die Definitionen waren unbemerkt über sechs Dateien hinweg auseinandergedriftet, die niemand für abgleichbedürftig gehalten hatte.
Ich zog die Definitionen in ein einziges gemeinsames Modul zusammen und band jeden Konsumenten daran an. Dieselbe Schicht enthält jetzt die Kalibrierung des Match-Scores: Bänder prognostizierter Passung werden rückwirkend gegen tatsächliche Interview-Ergebnisse getestet, sodass das System mir sagen kann, wenn seine eigenen Scores systematisch falsch liegen, statt der ersten Schätzung blind zu vertrauen. Das ist dbt-artige Semantic-Layer-Disziplin, übertragen auf ein System im persönlichen Maßstab, und es ist das Stück, das ich einem Data Engineer als Erstes zeigen würde.
Wo das Sprachmodell nicht zum Einsatz kommt
Die nächste Entscheidung, die es zu benennen lohnt, ist, wo der deterministische Code aufhört und das Sprachmodell beginnt.
Der Scanner von applyd spricht die APIs von Greenhouse, Ashby, Lever und Workable direkt an. Er zahlt null Tokens pro Durchlauf. Ein portalübergreifender Dedup-Pass fasst dieselbe Stellenanzeige zusammen, wenn sie auf mehreren Boards erscheint. Ein Zero-LLM-Lint setzt die CV-Qualitätsregeln (verbotene Wörter, verbotene Konstruktionen, Regeln für Gedankenstriche) als reine regelbasierte Prüfungen durch, die das Modell niemals aufrufen. Das Modell kommt nur dort ins Spiel, wo Urteilsvermögen gefragt ist: bei der Bewertung der Stellenanzeige gegen meinen CV, beim Verfassen des zugeschnittenen Anschreibens und beim begrenzten QA-Loop über den generierten CV.
Jeder LLM-Aufruf hat eine definierte Rolle und einen begrenzten Output. Nichts wird dem Modell überlassen, was eine deterministische Prüfung erledigen kann. Die Gründe sind Kosten, Latenz und Vertrauen. Sprachmodelle sind gut in Urteilsarbeit und teuer, wenn man sie in einer Schleife betreibt; deterministischer Code ist günstig, testbar und erfindet nie ein Keyword. Wer diese Grenze falsch setzt, verschwendet Geld oder verliert den Überblick darüber, was das System tut.
Ein Tracker, der mir gehört
Notion ist das System of Record. Beim ersten Start legt applyd über die Notion-API eine Applications-Datenbank mit einem kanonischen Schema an: neun Pipeline-Stufen von Discovered bis Offer, Deduplizierung nach Job-URL, die vor jedem Insert durchgesetzt wird, und drei Dashboard-Ansichten (ein Pipeline-Kanban, eine nach Match-Score sortierte Tabelle und ein Board mit aktiven Interviews). Ein lokaler Markdown-Tracker läuft parallel als Cache und portabler Fallback.
Die interessante Design-Frage war nicht die API-Integration. Es war der Kontrakt: welche Felder der Agent besitzt, welche der Mensch besitzt, und wie Konflikte gelöst werden, wenn beide in dieselbe Zeile schreiben. Dieser Kontrakt ist in einer einzigen Datei definiert und wird bei jedem Schreibzugriff durchgesetzt.
Das Register
Der UK-Sponsor-Check ist das kleinste Stück des Systems und dasjenige, das ich am meisten nutze.
Jeder UK-Arbeitgeber, der bei einem Scan auftaucht, wird gegen eine lokal gecachte Kopie des lizenzierten Sponsor-Registers von gov.uk abgeglichen, bevor applyd auch nur ein Wort verfasst. Nicht lizenzierte Arbeitgeber werden markiert und heruntergestuft; wenn ich Visum-Sponsoring brauche, können sie mir schlicht nicht helfen, egal wie gut die Rolle klingt. Die Pipeline behandelt das als harten Filter, der vor dem Verfassen greift. Er hat mir bereits drei Sonntagabende mit Bewerbungen erspart, die rechtlich aussichtslos waren.
Der Rest des Systems ist konzeptionell agentenneutral. Eine einzige Datei, AGENTS.md, definiert den Projektkontrakt, und ein Dispatcher leitet geplante Headless-Läufe je nach Umgebungsvariable an Adapter für die CLIs von Claude, Codex oder Gemini weiter. Dieselben Modi laufen unter jeder unterstützten Laufzeit. Für ein Ein-Nutzer-Werkzeug zählt das weniger als das Muster im Allgemeinen: Ein KI-integriertes System, das eng an die Laufzeit eines einzigen Anbieters gekoppelt ist, ist ein System, das sich nicht portieren lässt.
Was das Forken gelehrt hat, und was als Nächstes kommt
Vier Monate in fremdem Code lehren mehr als vier Monate an einem Greenfield-Projekt. Lesen vor dem Schreiben zwingt einen, ein Design zu verstehen, bevor man ihm widersprechen darf; wenn der Widerspruch kommt, muss er so formuliert sein, dass er die Möglichkeit des Irrtums offen lässt.
applyd ist auf GitHub, MIT-lizenziert und offen für Beiträge. Portal-Scanner für neue Märkte stehen oben auf der Liste, und jede Person, die im Vereinigten Königreich oder in der EU auf Jobsuche ist, kann es heute installieren. Santis career-ops ist ebenfalls auf GitHub, und für alle, die KI-integrierte Systeme bauen, sind die Mode-Routing-Architektur und die Never-Auto-Submit-Ethik die ersten beiden Dateien, die es zu lesen lohnt. Meine Ergänzungen (Semantic Layer, Notion-Kontrakt, Sponsor-Check, die Grenze zwischen deterministischem Code und LLM sowie die agentenneutrale Laufzeit) bauen auf seinem Code auf, und seine Arbeit verdient die volle Anerkennung.
Mein Ich aus dem Jahr 2023, jenes mit dem schmerzenden Rücken, dem ungeöffneten Tracker und dem Kaggle-Notebook, an dem ich nie weitergearbeitet habe, hätte das Ganze nützlich gefunden. Die aktuelle Version nutzt es jede Woche. Ich gehe davon aus, dass der Arbeitsmarkt mir weiterhin Gründe gibt, es zu nutzen.
applyd auf GitHub ansehen → Das ursprüngliche career-ops →
Quellen: Jobscan ATS Usage Report (2025); Harvard Business School / Accenture, "Hidden Workers" (2021); Huntr Job Search Trends (2025); Workday Global Workforce Report (2024); LinkedIn-Bewerbungsdaten via NYT (2025); Branchenberichte zum UK-Absolventenmarkt (2024 bis 2025); Greenhouse State of Job Hunting (2024 bis 2025); Congressional Research Service IF12977; SignalFire State of Tech Talent (2025); Federal Reserve Bank of New York, Labor Market for Recent College Graduates (Q1 2026); Stanford Digital Economy Lab / ADP, "Canaries in the Coal Mine" (2025 bis 2026).
Ich bin Analytics Engineer in Manchester, UK, und baue Datenplattformen mit dbt, Dagster und PostgreSQL.